4.5 · Os recomendadores intelixentes
En detalle
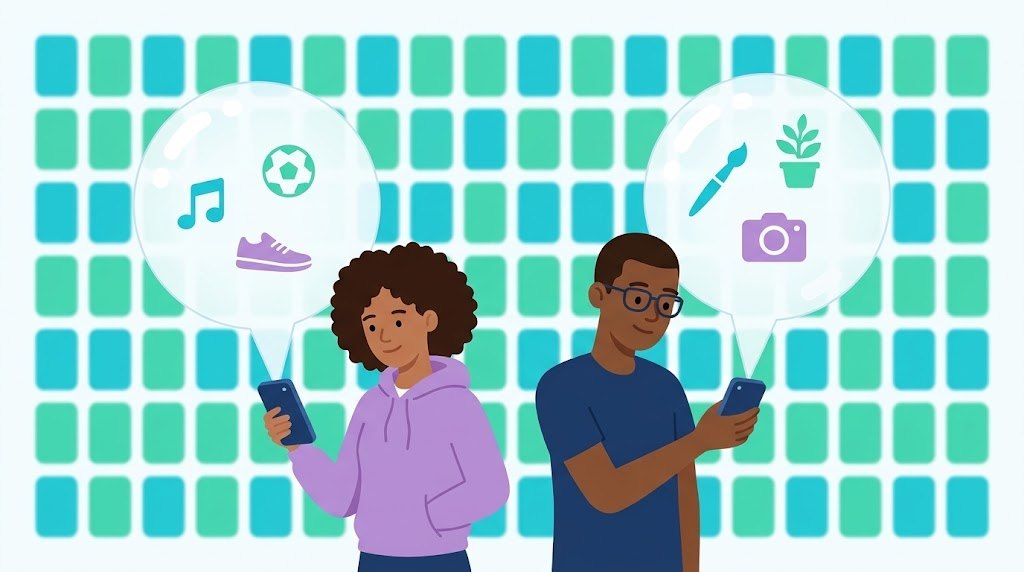
Un recomendador non adiviña o que che gusta: aprende de datos. Mira dúas cousas — o teu historial (que viches enteiro, que deixaches a medias, que repetiches) e o historial de xente que se comporta coma ti. Con iso ordena o catálogo e pon diante o que máis probablemente vas abrir.
Por iso dúas persoas ven portadas distintas na mesma plataforma o mesmo día: non cambiou o catálogo, cambiou o historial. E por iso un recomendador novo, sen datos, acerta pouco: aínda non ten de que aprender.
A área da intelixencia artificial que fai falta aquí é a aprendizaxe a partir de datos. Non precisa sensores nin mover nada: só datos e un modelo. Nese sentido parécese a un modelo preditivo, porque os dous anticipan algo a partir do que xa pasou; a diferenza está en que un anticipa un valor e o outro ordena unha lista.
O problema de que funcione demasiado ben
- Acerta moito co que xa che gusta, así que deixas de atopar cousas novas: é o filtro burbulla.
- O que non entra no teu historial tende a non aparecer nunca.
- A saída non é borrar a conta nin deixar a plataforma: é buscar a mantenta contido distinto do habitual, para darlle datos novos.
Grupos de 3. Cada grupo recibe da profesora unha lista de 12 películas/series con etiquetas (xénero, duración, idade) e 2 perfís de persoa usuaria (co seu historial).
- Escribide as regras do voso recomendador (p. ex.: «se viu 2 de comedia, suxerir outra comedia que non vise»). Mínimo 3 regras.
- Aplicade as regras aos 2 perfís e xerade 3 recomendacións por perfil, xustificadas coas regras.
- Comparade cos demais grupos: recomendastes o mesmo? Por que non?
- Reflexión final por escrito: que pasa se o recomendador só reforza o que xa che gusta? (filtro burbulla)
Para a PE: deste apartado saen preguntas de recoñecer o recomendador en casos reais (Netflix, YouTube, Spotify, tendas en liña).
4.5 · Los recomendadores inteligentes
En detalle
Un recomendador no adivina lo que te gusta: aprende de datos. Mira dos cosas — tu historial (qué viste entero, qué dejaste a medias, qué repetiste) y el historial de gente que se comporta como tú. Con eso ordena el catálogo y pone delante lo que con más probabilidad vas a abrir.
Por eso dos personas ven portadas distintas en la misma plataforma el mismo día: no cambió el catálogo, cambió el historial. Y por eso un recomendador nuevo, sin datos, acierta poco: todavía no tiene de qué aprender.
El área de la inteligencia artificial que hace falta aquí es el aprendizaje a partir de datos. No necesita sensores ni mover nada: solo datos y un modelo. En ese sentido se parece a un modelo predictivo, porque ambos anticipan algo a partir de lo ya ocurrido; la diferencia es que uno anticipa un valor y el otro ordena una lista.
El problema de que funcione demasiado bien
- Acierta mucho con lo que ya te gusta, así que dejas de encontrar cosas nuevas: es el filtro burbuja.
- Lo que no entra en tu historial tiende a no aparecer nunca.
- La salida no es borrar la cuenta ni dejar la plataforma: es buscar a propósito contenido distinto del habitual, para darle datos nuevos.
Grupos de 3. Cada grupo recibe de la profesora una lista de 12 películas/series con etiquetas (género, duración, edad) y 2 perfiles de persona usuaria (con su historial).
- Escribid las reglas de vuestro recomendador (p. ej.: «si vio 2 de comedia, sugerir otra comedia que no haya visto»). Mínimo 3 reglas.
- Aplicad las reglas a los 2 perfiles y generad 3 recomendaciones por perfil, justificadas con las reglas.
- Comparad con los demás grupos: ¿recomendasteis lo mismo? ¿Por qué no?
- Reflexión final por escrito: ¿qué pasa si el recomendador solo refuerza lo que ya te gusta? (filtro burbuja)
Para la PE: de este apartado salen preguntas de reconocer el recomendador en casos reales (Netflix, YouTube, Spotify, tiendas en línea).
4.5 · Les recommandeurs intelligents
En détail
Un système de recommandation ne devine pas ce que tu aimes : il apprend à partir de données. Il regarde deux choses — ton historique (ce que tu as regardé en entier, ce que tu as abandonné en route, ce que tu as répété) et l'historique de gens qui se comportent comme toi. Avec cela il classe le catalogue et met devant ce que tu vas le plus probablement ouvrir.
C'est pourquoi deux personnes voient des pages d'accueil différentes sur la même plateforme le même jour : le catalogue n'a pas changé, l'historique si. Et c'est pourquoi un système de recommandation neuf, sans données, se trompe souvent : il n'a encore rien à apprendre.
Le domaine de l'intelligence artificielle qu'il faut ici, c'est l'apprentissage à partir de données. Il n'a besoin ni de capteurs ni de bouger quoi que ce soit : seulement des données et un modèle. En ce sens il ressemble à un modèle prédictif, parce que tous deux anticipent quelque chose à partir de ce qui s'est déjà passé ; la différence, c'est que l'un anticipe une valeur et l'autre classe une liste.
Le problème quand ça marche trop bien
- Il vise très juste sur ce que tu aimes déjà, si bien que tu ne trouves plus rien de nouveau : c'est la bulle de filtres.
- Ce qui n'entre pas dans ton historique tend à ne jamais apparaître.
- La sortie n'est pas de supprimer le compte ni de quitter la plateforme : c'est de chercher exprès des contenus différents de d'habitude, pour lui donner de nouvelles données.
Groupes de 3. Chaque groupe reçoit de la professeure une liste de 12 films ou séries étiquetés (genre, durée, âge) et 2 profils d'utilisateur avec leur historique.
- Écrivez les règles de votre recommandeur (par exemple : « s'il a vu 2 comédies, en suggérer une autre qu'il n'a pas vue »). Trois règles minimum.
- Appliquez-les aux 2 profils et produisez 3 recommandations par profil, justifiées par vos règles.
- Comparez avec les autres groupes : avez-vous recommandé la même chose ? Sinon, pourquoi ?
- Réflexion finale écrite : que se passe-t-il si le recommandeur ne fait que renforcer ce que tu aimes déjà ? (bulle de filtres)
Pour l'épreuve écrite : de cette partie viennent des questions où il faut reconnaître le système de recommandation dans des cas réels (Netflix, YouTube, Spotify, boutiques en ligne).
4.5 · أنظمة التوصية الذكية
بالتفصيل
نظام التوصية لا يخمّن ما يعجبك، بل يتعلّم من البيانات. وهو ينظر إلى أمرين: سجلّك (ما شاهدته كاملًا، وما تركته في منتصفه، وما كرّرته) وسجلّ من يتصرّفون مثلك. وبذلك يرتّب الكتالوج ويضع في المقدّمة ما يُرجَّح أن تفتحه.
ولهذا يرى شخصان واجهتين مختلفتين في المنصّة نفسها واليوم نفسه: لم يتغيّر الكتالوج بل السجلّ. ولهذا يخطئ نظام توصية جديد بلا بيانات: لا شيء لديه ليتعلّم منه بعد.
مجال الذكاء الاصطناعي المطلوب هنا هو التعلّم من البيانات. فهو لا يحتاج مستشعرات ولا تحريك شيء: بيانات ونموذج فقط. وهو في ذلك يشبه النموذج التنبّؤي، لأنّ كليهما يتوقّع شيئًا انطلاقًا ممّا حدث سابقًا؛ والفرق أنّ أحدهما يتوقّع قيمة والآخر يرتّب قائمة.
مشكلة أن يعمل جيّدًا أكثر من اللازم
- يصيب كثيرًا فيما يعجبك أصلًا، فتتوقّف عن العثور على أشياء جديدة: هذه هي فقاعة التصفية.
- وما لا يدخل سجلّك يميل إلى ألّا يظهر أبدًا.
- والمخرج ليس حذف الحساب ولا ترك المنصّة، بل البحث عمدًا عن محتوى مختلف عن المعتاد، لتعطيه بيانات جديدة.
مجموعات ثلاثية. تتلقّى كل مجموعة من المعلّمة قائمة بـ12 فيلمًا أو مسلسلًا موسومة (النوع، المدة، العمر) وملفَّي مستخدِمَين مع سجلّ كلٍّ منهما.
- اكتبوا قواعد نظام التوصية الخاص بكم (مثال: «إن شاهد فيلمين كوميديين فاقترح كوميديا أخرى لم يشاهدها»). ثلاث قواعد على الأقل.
- طبّقوا القواعد على الملفَّين وأنتجوا ثلاث توصيات لكل ملفّ مبرَّرة بتلك القواعد.
- قارنوا مع المجموعات الأخرى: هل أوصيتم بالشيء نفسه؟ ولماذا لا؟
- تأمّل ختامي مكتوب: ماذا يحدث إن اكتفى نظام التوصية بتعزيز ما يعجبك أصلًا؟ (فقاعة التصفية)
للاختبار الكتابي: من هذا القسم تأتي أسئلة للتعرّف على نظام التوصية في حالات واقعية (Netflix، YouTube، Spotify، المتاجر على الإنترنت).